English | 日本語
Elixir の関数が回路になるまでの、内部の流れを説明します。Elixir と、デジタル回路の基本
(クロック、レジスタ、組み合わせ回路)を知っている人を想定しています。何が書けるかは
リファレンス(英語。EHLS.defhls/2、EHLS.Pipeline) を見てください。
全体の流れ
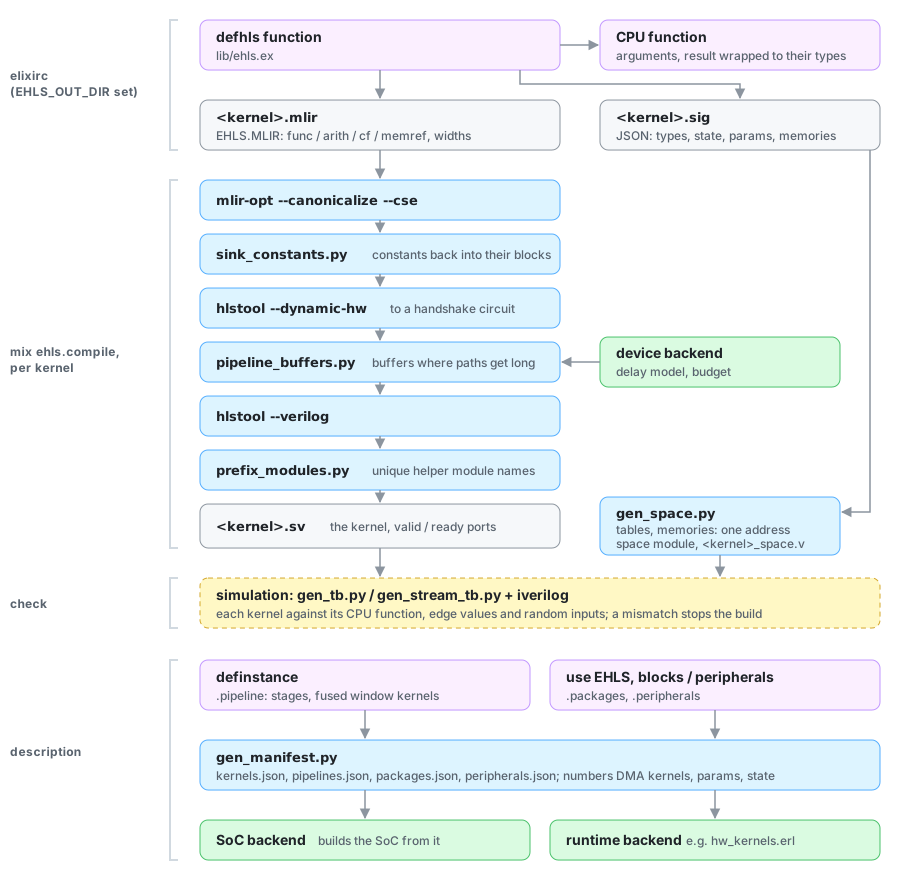
大きく分けて、4 つの段階があります。CPU から呼ぶ部分は、最後に説明します。
- Elixir のコンパイルのときに、
defhlsの関数を MLIR に書き出す。 mix ehls.compileが、MLIR を CIRCT で回路(SystemVerilog)にする。- できた回路を、元の Elixir の関数とシミュレーションで照合する。
- インスタンスの構成を、SoC とランタイムのバックエンドに渡す説明にまとめる。
1. Elixir の関数から MLIR へ
defhls(lib/ehls.ex。処理は lib/ehls/compiler.ex)はマクロです。関数の定義を受け取って、2 つのものを作ります。
- CPU の関数: 元の本体を、そのまま Elixir の関数として残します。ただし、引数と結果は、 宣言した型の幅に切り詰めます。回路は宣言した幅でしか値を持てないので、CPU でも同じ幅で 計算させて、両者の結果を一致させるためです。
- モジュールの最後でまとめて処理:
defhlsとdefinstanceは、定義をいったん覚えておき、@before_compileで処理します。同じ名前の 節をまとめ、呼ばれる関数から順に作るためです。 case、cond、複数の節: 回路のためには、AST の上で入れ子のifに直します(lib/ehls/syntax.ex)。CPU の関数は、書いたとおりです。- 呼び出しの展開: ほかの
defhlsの呼び出しは、MLIR に訳す前に、AST の上で本体に置き換えます(lib/ehls/inline.ex)。引数と結果はsigned/unsignedで包み、変数は呼び出しごとに別の名前にします。定数は定数のまま残るので、展開のあとでもシフトや表の参照は配線で済みます。 - 回路の元: コンパイルのときに環境変数
EHLS_OUT_DIRが設定されていれば、本体を MLIR に 訳して<kernel>.mlirに書き出します(EHLS.MLIR)。あわせて、型、状態、レベル、 メモリを JSON にした<kernel>.sigを書き出します。.sigは、あとの工程とターゲットが、 カーネルの入出力を知るために使います。
MLIR は、LLVM のプロジェクトの一つで、コンパイラの中間表現を作るための枠組みです。目的ごとに
「方言」(dialect)と呼ぶ命令の集まりがあり、Elixir HLS は、そのうち標準的なもの(func、
arith、cf、memref)だけを使います。四則演算やビット演算は arith になります。if は、中に
ループがなければ、両方の結果を計算してから選ぶ形(arith.select)になり、ループと、ループを
含む if は cf の分岐になります。メモリとテーブルは memref になります。
値のビット幅は、演算から決めます。たとえば、+ は 1 ビット、* は両辺の幅の和だけ広げ、
途中の計算があふれないようにします。そのうえで、関数の結果を宣言した型に切り詰めます。
これも、CPU の関数と同じ動きです。
2. MLIR から回路へ(CIRCT)
CIRCT は、MLIR の上に作られた、回路のためのコンパイラの基盤です。Elixir HLS は、CIRCT の
hlstool --dynamic-hw で MLIR を回路にします。この方式(動的スケジューリング)では、
すべての値に valid と ready の信号が付き、値は、受け取る側の準備ができたときに流れます。
どのクロックで何を計算するかを前もって決めなくても、ループや分岐を含む関数が、そのまま
動く回路になります。その代わり、ハンドシェイクの分だけ回路が大きくなります。
mix ehls.compile(priv/hls_compile.sh)は、カーネルごとに次の順で処理します。
mlir-opt --canonicalize --cse: 定数のたたみ込みや、同じ計算の重複を除く、 MLIR の標準の整理です。sink_constants.py: 1 の整理は、定数を関数の先頭にまとめてしまいます。動的 スケジューリングの回路では、ループの後で使う定数が、ループを回るたびに変数のように 回路の中を運ばれてしまいます。それを避けるため、定数を、使う場所の近くに戻します。hlstool --dynamic-hw: ハンドシェイクの回路にします(この段階ではまだ MLIR の形です)。pipeline_buffers.py: ハンドシェイクの回路では、レジスタ(バッファ)のない所は、 値が 1 クロックの間に組み合わせ回路を通り抜けます。その経路が長いと、クロックに 間に合いません。CIRCT のバッファの入れ方は、ほとんど入れないか、すべての経路に入れるかの どちらかしかありません。前者では、あるデエンファシスのフィルタが 28 段の論理になり、50 MHz に 届きませんでした。後者では、レジスタが大量に増えます。そこで、演算ごとの遅延を見積もり、経路の遅延が 目安を超える所にだけ、バッファを入れます。見積もりの値と目安は、デバイスのバックエンド (EHLS.Device)が決めます(DELAY_MODEL/PIPE_BUDGET)。あわせて、ループのバッファを 1 段にして、ループ 1 回あたりのクロック数を減らします。hlstool --verilog: SystemVerilog に書き出します。prefix_modules.py: CIRCT は、補助のモジュールに、演算から決まる名前を付けます。 名前はどのカーネルでも同じなので、1 つの SoC に複数のカーネルを入れるとぶつかります。 そこで、補助のモジュールの名前の頭に、カーネルの名前を付けます。
テーブルとメモリは、カーネルごとに、1 つのアドレス空間のモジュール(<kernel>_space.v、
gen_space.py)にまとめます。CIRCT 1.160 の hlstool が、1 つのカーネルにつき 1 つのメモリ
(memref)しか扱えないためです。読み出しは 1 クロック遅れて出る形にしてあり、FPGA のツールが
ブロック RAM を使えるようにしています。
3. シミュレーションでの照合
どのカーネルも、iverilog でシミュレーションし、CPU の関数と結果を比べます(gen_tb.py、
gen_stream_tb.py)。入力は、境界の値(0、最大値、符号の境目など)と乱数です。状態を持つ
カーネルは、初期の状態から一続きのデータを流し、途中で一度、状態を初期に戻して続けます。
結果が 1 つでも違えば、ビルドはそこで止まります。入力とテストベンチの詳しい仕様は、mix ehls.compile の
説明(mix help ehls.compile)にあります。
CPU の関数が仕様なので、ここで一致した回路は、仕様どおりに動くことが確かめられています。
4. インスタンスとターゲットへの説明
definstance(lib/ehls/compiler.ex、lib/ehls/pipeline.ex)は、パイプの各関数を、同じモジュールの defhls の関数か、
ブロック(EHLS.Blocks)に対応させます。chunk_every(n, k, :discard) |> map(&f/1) は、
直近の n 個のデータを持つリングバッファと、数を数える仕組みを足して、1 つのカーネルにまとめます。
n 個そろったところで最初の塊を計算し、そのあとは k 個ごとに計算します。
- 値のインスタンス(引数に型のあるもの。lib/ehls/level.ex)は、本体を 1 つのカーネルにし、hls_level_adapter.v の後ろに 置きます。CPU は引数のワードを書き、スタートの書き込みで全部を 1 クロックで取り込み、結果は、それがどのスタートの結果かの 番号と一緒に保たれます。
- ストリームのインスタンスは、本体からグラフとして組み立てます。合流をすべて
zip_with(a, b, &f/2)の形にし (lib/ehls/join.ex)、合流の間のパイプをそれぞれ関数の並びにし、合流と分岐(名前を付けて 2 回使ったストリーム)でつなぎます。 レベルと一緒に置いた関数(map(&f(&1, k_hw(:value))))は、引数 1 つのカーネルを生成し、レベルを配線します。合流は コンパイラのブロックhw__zip(その後に組を受け取る生成したカーネル)、分岐はhw__forkです。中で呼んだほかの インスタンスは、パイプの中のcallになります。 - 状態を持つ関数は、
transform(init, &f/2)と書いた場所に置きます。そこで作るカーネルf__s…は、2 つ目の引数を 状態として hls_state_adapter.v の後ろのレジスタに持ち、始めるときにinitを読み込みます。状態の中のタプル もレジスタで、変数の添字のelem/put_elemは選択の回路になります。memory: [:hist]を付けて置くと、タプルhist(lib/ehls/tuple_state.ex)は、カーネルf__m_histのメモリの引数になります。elemはその読み出し、put_elemの 書き込みはステップの終わりに、どの読み出しよりもあとに行います。状態の残りは、カーネルの状態です。メモリはカーネルの メモリ空間(priv/gen_space.py)の 1 つの領域で、始めるときに 0 で埋めます。名前を付けて (transform(..., memory: [:hist], name: :f))置くと、CPU はinst(:state, :f)で状態をまるごと読みます。値は ほかの名前付きの状態と同じく(peek)、メモリはメモリ空間の CPU 用の口(SoC のmem_addr/mem_data)から 1 語ずつ 読みます。CPU の読み出しは次のクロックで最優先に行い、カーネルはその 1 クロックだけ待ちます。どの語も、読んだときの値です。 - エージェント(
EHLS.Agent)は、1 つのレジスタ(hls_litex.py のAgent)を、その関数のアダプタが共有します (SHARED)。関数は、要素のあるものの間で順番に 1 つずつ、状態を受け取って次の値を返します。
インスタンスの構成は .pipeline(JSON)に書き出します。中身は、置いた関数の並び、関数の間の接続(種類、型、入る先の関数の入力
port、出る元の出力 from_port。分岐の出力)、CPU からの入力(それぞれどの関数に入るか)、出力(output_from)、値の
インスタンスなら level です。use EHLS, peripherals: [...] で指定した周辺回路は .peripherals に書き出します。
最後に priv/gen_manifest.py が、これらと各カーネルの .sig を、kernels.json、pipelines.json、
packages.json、peripherals.json にまとめます。ここでモジュールをまたいで説明を組み合わせます。カーネルのレベルを
レベルのインスタンスやピンにつなぎ、ほかのインスタンスの中で呼ばれたインスタンスをそこへつなぎます(wired。その入出力は
CPU との端になりません)。それぞれ、ビルドにあるか、型、呼ばれるのは 1 回か、ループがないかを確かめます。そして、
レベルのインスタンス、状態のワード(hold のワードも含む)、CPU との端、パッケージのレジスタに番号を振ります。SoC のバックエンドは、この説明から SoC を組み立てます。
ランタイムのバックエンドは、CPU 側のプログラムが同じ番号で回路を呼べるように、必要な
ものを作ります(AtomVM の場合は、番号を持つ Erlang のモジュール hw_kernels)。
5. CPU との端
インスタンスの引数と、ストリームのままの終わりは、CPU との端になります。設計の要点は、転送が NIF から戻ったあとも続く ことです。その間に、呼んだプロセスのヒープは GC で動くかもしれませんし、他のプロセスは動き続けなければなりません。
- 回路(hls_litex_blocks.py の
CPUIn、CPUOut): 端ごとに LiteDRAM の DMA エンジンを 1 つ置きます。エンジンは クロスバーの読み出し用と書き込み用のポートを 1 本ずつ共用し(SharedPort)、コマンドごとに順番に使います。端が増えても クロスバーは大きくなりません。エンジンは終えられる要求しか出さない(読み出しはデータの置き場所を先に確保し、書き込みは データを持ってから出す)ので、止まっている端、遅いソースや誰も読まない出力が、ほかの端を待たせることはありません。 どのコマンドが誰のものかを FIFO に覚えておき、データを振り分けます。終わりはfinishedという信号で知らせます。入力は最後のワードが DMA を出たとき、出力は最後のワードが SDRAM に向かったときに立ちます。入力の DMA は、止めると中の FIFO を捨てるので、done(読み出しの要求を出し終えた)では早すぎます。buffer:は、出力の DMA の手前に置くブロック RAM の FIFO です。 - 割り込みとメッセージ(src/hwstream_nif.c):
finishedの立ち上がりが、端ごとのイベントとして 1 つの割り込みにまとまります。 割り込みはシステムのワークキューに渡すだけで、ワークキューがメッセージを送ります(イベントの待ち行列も同じ形です)。 取り消した転送の割り込みが遅れて届いても誤解しないように、ワークキューはfinishedを読み直します。 - メモリ: 出力は、ドライバが持つ refc バイナリに書き、メッセージで渡します。入力は、refc バイナリで、4 バイト境界にあり、SDRAM の中にあるなら、参照を増やしてその場で読みます。それ以外(小さいもの、フラッシュのリテラル、境界がずれたもの)は先にコピーします。 CPU の D キャッシュはライトスルーなので、出力の転送のあとに無効化するだけで済みます。
- 次の転送: 端は、転送中にもう 1 つ受け付けます(
end_send、end_request)。割り込みの処理が、前の転送が終わり次第 それを始めるので、プログラムを待たずにストリームが続きます。それ以上は busy を返します。 - DMA を使わない 1 要素(
f(:send, :x, v)): 詰めたワードを、NIF の中から入力の端の小さな FIFO(DMA の前)に入れます (end_push)。メッセージは来ません。 - イベント: 出した側のイベントは、時刻と一緒に FPGA の中の 1 本の待ち行列に順に入ります。その割り込みで NIF の中の
リングに移し、work queue がトピックの受け取り手(トピックごとに 4 つまで)に送ります。すべて送るか、
active:なら 次の n 個まで送って、それより後は(16 個まで)次に頼まれるまで取っておきます。 - 同期の呼び出し(lib/ehls.ex):
f(bin)などは、同じメッセージの転送を頼んでreceiveで待つ、Elixir のコードです。 待っているのは呼んだプロセスだけです。時間切れのときは転送を取り消し、届きかけのメッセージを捨てます。
止めるときは、カーネルが始めた要素を最後まで処理させて、その出力を捨てます。途中で止めると、その要素が 再開のあとに古い状態から出てくるからです。カーネルが手を離したら、リンクとバッファを空にします。
6. CPU の上で
CPU に置いたインスタンス(on: :cpu、または FPGA がないとき)は、回路ではありません。
- CPU の上のインスタンス(lib/ehls/cpu_instance.ex): インスタンスの名前で登録したプロセスです。呼び出しをまたいで
各関数の状態を持ち、渡されたリストに関数を通します。
ticksの入力元はタイマーで動きます。 - 機械語で(
cpu: :nif): 関数を、Elixir ではなく C で動かします。lib/ehls/nif.ex が、各カーネルの MLIR から C を書き (mix ehls.compile --target cpu。ホストで関数と照合します)、ランタイムのバックエンドがそれを NIFhwnif(src/ehls_nif.c)に組み込みます。EHLS.NIFRunは長い入力を小分けにして、呼び出しの合間に VM のほかのプロセスを動かします。 - インスタンスの関数 1 つを CPU で(
map(&f/1, on: :cpu)、lib/ehls/cpu_stage.ex): インスタンスをそこで切ります。前の部分は CPU との端で終わる回路<name>__pre、後の部分は端から始まる回路<name>__postになり、EHLS.CpuDriver(プロセス)が、 前からストリームを受け取り、関数の NIF に通して、後へ渡します。関数のレベルは、ドライバがひとまとまりごとに読みます。 - EHLS.Server(lib/ehls/server.ex): インスタンスを持つ GenServer です。アプリケーションと一緒にインスタンスを始めて止め、 呼び出しを順番に受け、トピックのイベントをいくつのプロセスにでも渡します。
バックエンド
ハードウェアに依存する部分は、デバイス、SoC、ランタイムの 3 種類のバックエンドにあります。
| 種類 | バックエンド | モジュール | ファイル(priv/backend/) | 受け持つこと |
|---|---|---|---|---|
| デバイス | generic | EHLS.Device.Generic | — | pipeline_buffers.py の遅延の見積もりと目安 |
| デバイス | gowin_gw5a | EHLS.Device.GowinGW5A | gowin/ | 遅延の見積もりと目安。check_timing.py(Gowin のタイミングの報告を検査)、gowin_litex.py(Gowin 向けの LiteX のツールの設定、ピンのプルの制約) |
| SoC | litex | EHLS.SoC.LiteX | litex/ | hlslitex.py: インスタンスのパイプの各関数をレジスタでつなぐ(時分割のカーネルの前は FIFO)。レベルのインスタンス、カーネルにつないだレベル、状態を CSR(`hwstream*)で読み書きできるようにする。ブロックのパッケージの Python のモジュールを組み込む。組み込みのブロックは hls_litex_blocks.py(EHLS.SoC.LiteX.Blocks)、EHLS.GPIO` の回路は ehls_gpio.py |
| ランタイム | atomvm | EHLS.Runtime.AtomVM | atomvm/ | :hwstream の NIF(src/hwstream_nif.c)とそのスタブ、CSR のヘッダ(gen_csr_header.py)、hw_kernels.erl(gen_hw_kernels.py)。litex が必要 |
EHLS.Backend は、ビルドごとに 3 種類から 1 つずつ選び(EHLS_DEVICE / EHLS_SOC /
EHLS_RUNTIME、または config)、組み合わせられるかを確かめます。use EHLS も、
ブロックのパッケージが、使っている SoC のバックエンド向けであることを確かめます。
ランタイムのバックエンドがなければ(既定)、defhls / definstance は CPU の関数だけを
作ります。